
AI roboti vykrádají internet. Obsah berou zadarmo, autorům nic nevrací a weby stahují pořád dokola
Nechtějí výkupné ani data zákazníků. Chtějí všechno, co je na webu, a to opakovaně. Crawlery sbírající data pro umělou inteligenci se naučily vypadat jako běžní návštěvníci, chodí z desítek tisíc domácích IP adres a obcházejí CDN, firewally i ochranné výzvy. Provozovatelé webů za jejich provoz platí výkonem serverů a penězi, návštěvníky ale nedostanou. Poprvé v historii webu tak roboti netvoří jen jeho okrajovou zátěž, ale většinu provozu.

„Za noc zase přišla armáda robotů z celého světa rabovat, co může.“
Tak začínal srpnový příspěvek na Facebooku, ve kterém jsem jako vývojář a správce řady webů popsal, co se na nich děje. Během pár dní pod ním byly desítky komentářů od lidí, kteří řeší totéž: vývojářů, správců serverů, provozovatelů e-shopů i autorů malých blogů.
Příběhy se opakují. Web najednou zpomalí, databáze se zahltí a zátěž serveru vyskočí na násobky obvyklých hodnot. V logu není jedna podezřelá IP adresa ani útočník, kterého by šlo jednoduše zablokovat. Jen tisíce „návštěvníků“, kteří vypadají jako lidé, ale lidmi nejsou.
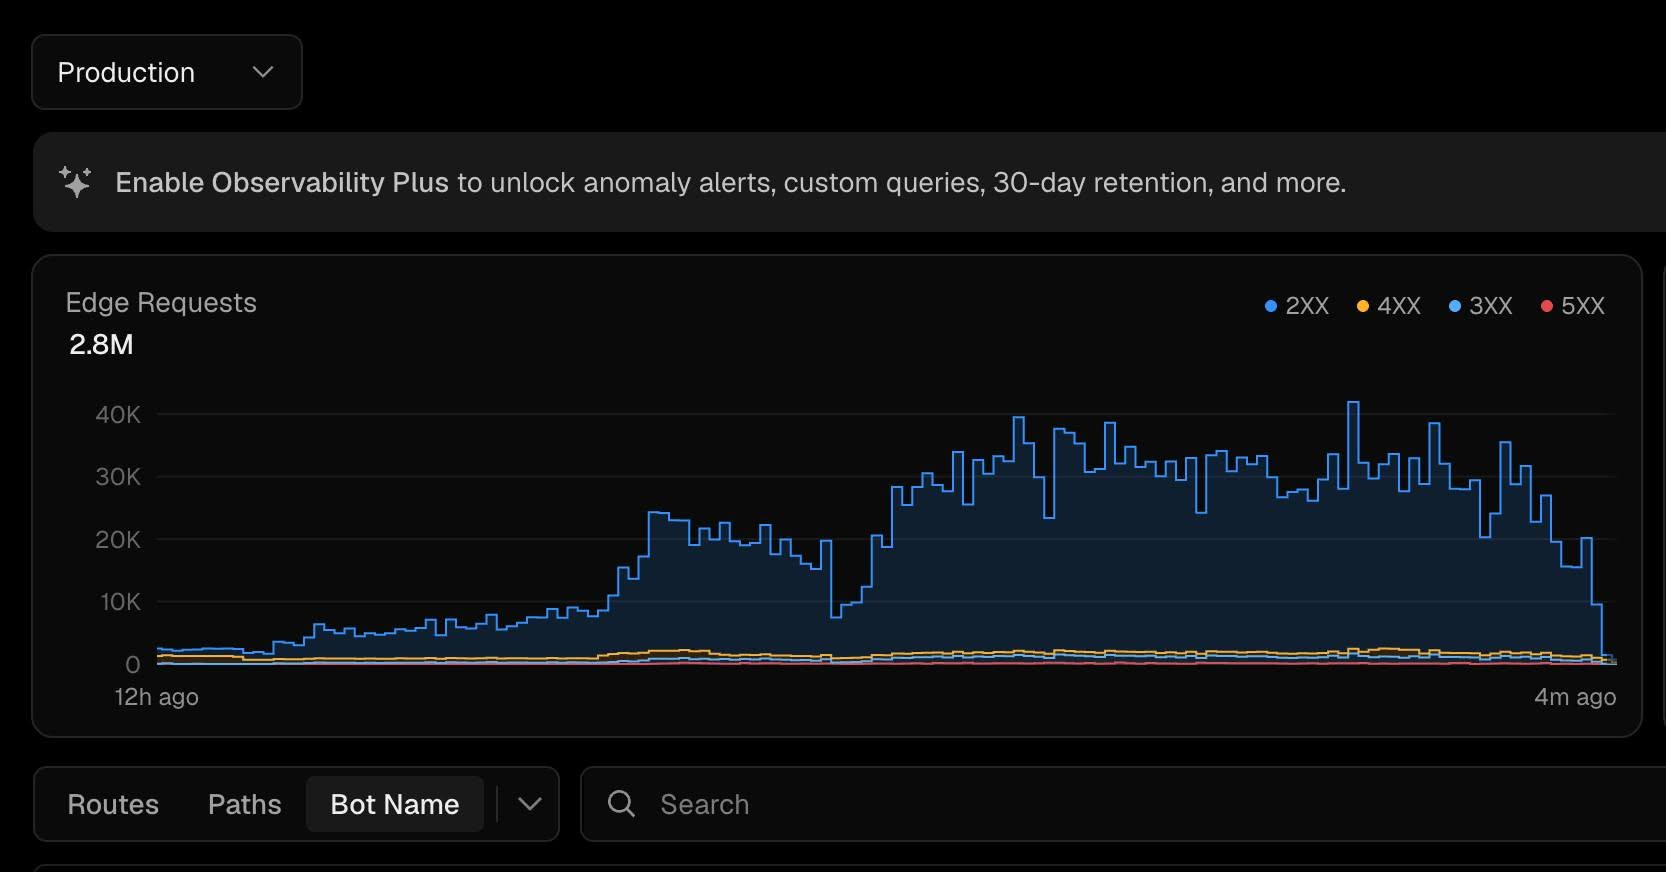
Nejde o jednotlivý incident. Jde o nový problém, který postihuje celý internet najednou.
Většina webového provozu už není lidská
Rozsah automatizovaného provozu ukazují data Cloudflare Radaru. Podle údajů, které v červnu 2026 zveřejnil šéf Cloudflaru Matthew Prince, připadalo v síti společnosti 57,5 % požadavků na HTML stránky na automatizované klienty a 42,5 % na lidi. Údaj zahrnuje různé typy botů, nejen crawlery sbírající data pro AI.
Roste i objem požadavků od AI agentů. Společnost DataDome zaznamenala ve druhém čtvrtletí 2026 ve své síti 17,7 miliardy takových požadavků, o 45 % více než v prvním čtvrtletí. Běžná klientská analytika nemusí značnou část automatizovaného provozu zachytit, zatímco v serverových logách se projeví.
Google bral a vracel. AI jen bere
Vyhledávače weby procházely odjakživa, ale fungovala tichá dohoda: provozovatel zaplatí za provoz robota a vyhledávač mu pošle návštěvníky. U AI crawlerů tato dohoda často neplatí.
Cloudflare měří poměr požadavků na HTML stránky k návštěvám, které daná platforma přivede zpět. V červnu 2025 připadalo na jednu přivedenou návštěvu zhruba 14 požadavků Googlu, 1 700 požadavků OpenAI a 73 000 požadavků Anthropicu. Poměry se výrazně mění v čase: Cloudflare Radar za 28 dní do 21. července 2026 uváděl přibližně 2 237 : 1 pro Anthropic, 217 : 1 pro OpenAI a 4,6 : 1 pro Google. Rozdíl ale zůstává v řádech. Výpočet nemusí zachytit všechny návštěvy z nativních aplikací, které nepředávají informaci o zdroji návštěvy.
Roboti navíc procházejí web za různým účelem. Podle Cloudflaru tvořily v červnu 2026 požadavky crawlerů určených k tréninku AI přibližně 52 % provozu crawlerů, jejichž účel společnost rozlišuje. Více než 36 % připadalo na roboty se smíšeným využitím, které může zahrnovat vyhledávání, asistenty i trénink. Samotné stažení stránky proto ještě neříká, zda se její obsah později objeví v odpovědi uživateli nebo zda na ni služba přivede návštěvníka.
„Oni tě nepotřebují jako Google, který na tebe potom ještě odkazuje. Oni tě jenom vysosnou a čus, protože tvoje data potom vydá AI model u nich na webu, a často bez zdroje,“ napsal jsem v srpnovém příspěvku. Tréninkové týmy nemají ekonomický důvod chovat se ohleduplně, protože jejich byznys na zdrojovém webu nezávisí.
A to jsou jen oficiální, ověření roboti, kteří se poctivě představí. Crawlery, které se vydávají za běžný prohlížeč, přitom statistiky založené na rozpoznání známých botů nemusejí zachytit.
Stahují všechno a pořád dokola
Kdyby si každý web stáhli jednou, byl by to jen nepříjemný jednorázový náklad. Problém je, že se to neustále opakuje, a to z několika důvodů.
Každý poskytovatel AI má vlastního robota. Stejný obsah si tedy stahuje OpenAI, Anthropic, Meta, čínské firmy, desítky menších laboratoří a stovky neznámých projektů. Každý znovu a každý chce data průběžně aktualizovat.
Z logů vidím, že některé URL dostanou i desítky požadavků po sobě. Bez dalších dat ale nedokážu určit, zda jde o instance téhož crawleru, nebo o různé roboty.
Jdou do hloubky, kam nikdo jiný nechodí. Google si drží v indexu omezený počet stránek a zbytek prochází jen výjimečně. AI crawler zkouší nesmyslné kombinace parametrů, a když pochopí, jak web skládá adresy, začne je hádat. Nejraději chodí tam, kde není cache: na hluboké stránky stránkování, filtry a kategorie, které se musí pokaždé spočítat nad databází.
Proto může mít klasická obrana v podobě cache omezený účinek. Pokud robot žádá stránky, které se běžně téměř nenavštěvují, musí je web často znovu připravit místo toho, aby je rovnou vydal z cache. Cloudflare upozorňuje, že AI crawlery procházejí i rozsáhlé části webů mimo nejnavštěvovanější stránky a jejich požadavky nemusí sledovat efektivní cestu. Uvádí také, že podle statistik projektu Common Crawl je více než 90 % jím procházených stránek obsahově unikátních. Tento údaj se však vztahuje ke Common Crawl, nikoli ke všem AI crawlerům.
Robot tak často najde drahé místo ve webu dřív než jeho autor. Zapomenutou funkci, neoptimalizovaný dotaz nebo stránku, kterou si člověk nikdy nezobrazí. Pro robota je to jen další URL.
Když web zvládá, přidají
Nejvíc provozovatele překvapuje agresivita. Robot si nejdřív zkusí pár desítek požadavků. Když web odpovídá, přijdou tisíce. A když to web vydrží i potom, zátěž může dál růst až k přetížení databáze.
U webů s autoscalingem může nastat ještě horší varianta: pokud nejsou nastavené limity, provozovateli spolu se zátěží roste faktura za cloud.
„Tohle by mělo mít horní limit,“ shrnul jsem v diskusi.
Klasická obrana přestává stačit
Ještě před pár lety se nadměrný provoz dal obvykle vystopovat k jednomu viníkovi, konkrétní firmě nebo rozsahu IP adres, který šlo odříznout. Dnešní crawlery tuhle možnost berou:
- Chodí z desítek tisíc unikátních IP adres, často z rezidentních sítí, tedy z běžných domácích připojení. Z jedné adresy přijde třeba jen pár požadavků.
- User-Agent se tváří jako běžný prohlížeč. Podle hlavičky je od člověka nerozeznáte.
- Umí přijít i přes české rezidentní sítě, proxy a VPN, takže je nezastaví ani geoblokace.
- Vyplatí se jim stránku plně vyrenderovat v Chromu a spustit JavaScript, aby prošly i ochrannými výzvami.
Část provozu navíc tvoří open source crawlery, které lidé dobrovolně provozují na svých počítačích a pomáhají tak sbírat data. Výpočetní výkon je levný, disky také, konektivita taky.
Weby se začínají vypínat
Pro menší provozovatele je nejsnazší obranou web vypnout. Sám jsem k 1. září 2026 vypnul několik starších obsahových webů. Vedou na ně desítky kvalitních odkazů, ale přes půl milionu požadavků denně na nich generovali jen roboti, kteří se dostali přes Cloudflare proxy, dva firewally až na aplikační server. Lidí přicházelo pár jednotek denně, protože obsah si dnes čtou přes AI.
Platit zhruba 16 tisíc korun měsíčně jen za frontend webů, kam nechodí lidé, nedává smysl.
Podobné zkušenosti se objevily i v diskusi. Autorka, která dříve provozovala řadu webů, popsala, že většinu z nich vypnula, protože užitečný obsah už nemá jak monetizovat. Uživatelka hostingové platformy poprvé v historii narazila na limity přenesených dat a web se jí vypínal. Další provozovatelé přesunuli obsah za registraci.
Na světové scéně musela část veřejných open source projektů kvůli stejnému problému předplatit CDN nebo nasadit Anubis, JavaScriptovou výzvu v prohlížeči, která má odfiltrovat automaty.
Co radí lidé z praxe
Z desítek komentářů pod mými příspěvky vzešel přehled toho, co provozovatelům skutečně pomáhá. Žádné opatření není univerzální, ale kombinace několika z nich dokáže zátěž výrazně snížit.
Geoblokace. Nejdrastičtější, ale okamžitě účinná. Provozovatel českého a slovenského e-shopu popsal, že po zakázání veškerého provozu mimo ČR a SR klesl provoz o 99,8 %, prodeje se nezměnily a web přestal padat, zatímco předtím padal i desetkrát denně. Jiný správce blokuje celé autonomní systémy (ASN): skoro celou Jižní Ameriku, Čínu, Rusko a část rezidentních sítí v USA.
Ověřování legitimních robotů. Google popisuje ověření svých crawlerů pomocí zveřejněných rozsahů IP adres nebo kombinace reverzního a následného dopředného DNS dotazu. Díky tomu lze ostatní provoz posuzovat přísněji, aniž by správce omylem zablokoval skutečného Googlebota.
Nízké limity a dlouhé bany. Několik diskutujících sdílí stejný recept: nízký rate limit, rychlé vyhodnocování a dlouhodobý ban pro každého, kdo nereaguje na HTTP 429. Člověk na chybové hlášení obvykle zareaguje, robot ne. Jeden správce banuje každého, kdo stáhne víc než pět stránek za 30 sekund, jiný po sérii podezřelých nebo chybových požadavků z jedné IP.
Vrstvená obrana. Osvědčená sestava z diskuse: Cloudflare, firewall, nginx s fail2ban a teprve pak aplikační server. Další uživatelé chválí komunitní nástroj CrowdSec, který sdílí reputaci útočících IP adres.
Cookies a výzvy. Požadavek bez cookie přesměrovat na mezistránku s krátkým čekáním. Robot to často vzdá, člověk počká nebo klikne, nastaví se cookie a dál už web funguje normálně. Podobně fungují JS výzvy typu Anubis nebo Turnstile. Nejpokročilejší roboti je ale už umí projít.
Náročné části jen pro přihlášené. Statické stránky nechat otevřené, ale fóra a další drahé části zpřístupnit jen přihlášeným uživatelům nebo těm, kdo se nedávno přihlásili. Ostatní dostanou tvrdý limit podle lokality IP adresy.
Zlevnit každý požadavek. Statické HTML, edge cache, předgenerovaná data místo dotazů do databáze. Jeden vývojář popsal, že přes Cloudflare CDN a cachování servíruje přes 10 milionů požadavků denně a jeho backend přitom běží na malém Raspberry Pi. Jiní přecházejí na statické generátory typu Astro. A hlavně: projít kód a najít drahé operace, které se spouštějí zbytečně.
Pasti na roboty. Někteří provozovatelé nasazují takzvané tarpity, které robotům generují nekonečné množství nesmyslných stránek. Pozor ale na weby s autoscalingem, kde past zaplatíte vy. Jeden autor blogu popsal, že mu jeho past nakonec položila server.
Ne všichni to vidí stejně
Diskuse ukázala i opačné pohledy. Část provozovatelů AI roboty vítá: pokud si jejich značku zapamatuje AI model a bude ji doporučovat, je jim jedno, kolikrát si web stáhne. AI podle nich bude primárním kanálem, jak lidé hledají informace, a blokovat ho je krátkozraké.
Jiní připomínají, že i Google zpočátku obsah jen stahoval a byznys model, ze kterého profitují weby, vznikl až později. Další upozorňují, že velké AI firmy robots.txt deklarativně respektují a jejich modely stále častěji uvádějí zdroje.
Problémem ale nejsou roboti, kteří se představí a respektují pravidla. Problémem jsou ti, kteří se skrývají za tisíci domácích IP adres, maskují se jako lidé a stahují stejný obsah pořád dokola. Ty žádný robots.txt nezastaví.
Kdo zaplatí web, ze kterého se AI učí?
Otevřený web stál na jednoduché dohodě: někdo vytvoří obsah, provozuje ho na vlastní náklady a na oplátku k němu přicházejí lidé. AI crawlery tuto dohodu rozbíjejí. Náklady zůstávají autorům, hodnotu si odnášejí jiní.
Pokud to tak zůstane, bude na otevřeném webu kvalitního obsahu ubývat. Bude se schovávat za paywally, registrace a ochranné výzvy, nebo úplně zmizí. A pak se nebude mít z čeho učit ani sama umělá inteligence.
Pro provozovatele webů je už teď jasné jedno: nové weby je potřeba stavět s tím, že výraznou část jejich provozu mohou tvořit stroje. Kdo s tím nepočítá, zjistí to z faktury za server, nebo ve chvíli, kdy mu web přestane odpovídat.
Zdroje
- Jan Barášek – srpnový příspěvek a diskuse na Facebooku
- Cloudflare – poměr procházení webu a přivedených návštěvníků v červnu 2025
- Cloudflare Radar – AI Insights
- Cloudflare – rozdělení provozu crawlerů podle účelu
- DataDome – zpráva o provozu AI agentů za 2. čtvrtletí 2026
- Cloudflare – vliv AI crawlerů na využití cache
- Google – ověřování požadavků od crawlerů